Réseau vérifié avant livraison
On lance un benchmark NCCL all-reduce sur tout le cluster. Le rapport part avec vos identifiants, vous savez exactement ce que le réseau donne.
Quand un seul nœud ne suffit plus, Tensorfoundrycorp assemble plusieurs machines en un cluster InfiniBand. Vous entraînez des modèles de plusieurs centaines de milliards de paramètres sur 8, 32 ou 512 GPU, avec un seul point d'entrée et un seul interlocuteur.
Réservation longue
Ces machines se réservent au mois, parce qu'un entraînement distribué ne supporte pas qu'on lui coupe l'herbe sous le pied en plein milieu. On bloque donc les nœuds pour vous.
Le vrai sujet, ce n'est pas le nombre de cartes, c'est ce qui passe entre elles.
Un entraînement réparti sur 64 GPU peut très bien être plus lent que le même job sur 8 GPU si l'interconnexion est mauvaise. C'est pour ça qu'on ne bricole pas : chaque nœud est relié par InfiniBand 400 Gb/s, on dimensionne le réseau en fat-tree, et on vérifie le débit inter-nœuds avant de vous livrer. Vous récupérez ensuite un cluster prêt pour du tensor parallélisme, du pipeline parallélisme ou du FSDP sans avoir à négocier la couche réseau.
On adapte la taille à votre modèle. Pas besoin de prendre 512 cartes si 32 suffisent.
Chaque machine dispose de sa propre liaison, elle ne partage pas la bande passante avec ses voisines.
Un chiffre vérifié avec un benchmark NCCL avant chaque mise en production du cluster.
C'est ce que nos clients mettent en moyenne pour boucler un run complet. Libre à vous de prendre plus court ou plus long.
On a construit ce service en partant de nos propres galères : des jobs qui plantent au bout de 40 heures parce qu'un nœud a des latences réseau irrégulières.
On teste le cluster avant livraison. Si un nœud tient mal la charge, il ne sort pas.
On lance un benchmark NCCL all-reduce sur tout le cluster. Le rapport part avec vos identifiants, vous savez exactement ce que le réseau donne.
Un stockage partagé de 200 To est inclus pour vos checkpoints. Si un nœud lâche, votre run repart du dernier point sans perdre 30 heures de calcul.
Au-delà de 32 GPU, vous avez un contact technique nommé, joignable sur un canal direct. Pas de ticket qui traîne dans une file.
Les prix sont mensuels, engagement de 30 jours par défaut. On peut descendre jusqu'à 90 jours pour obtenir un meilleur tarif.
Le bon point d'entrée pour du fine-tuning de gros modèles ou un premier run distribué.
Demander un devisÀ partir de 30 jours d'engagement, le tarif par nœud baisse mécaniquement.
Discuter du projetOn construit l'offre avec vous, pas à partir d'un catalogue figé.
Nous écrireTarifs HT, engagement 30 jours minimum. Un devis précis vous est envoyé après un échange technique de 30 minutes.
D'un premier contact à un cluster opérationnel, il faut en général entre trois et dix jours ouvrés, selon le volume.
Une demi-heure pour comprendre la taille de votre modèle, votre stratégie de parallélisme et la durée de réservation visée.
On décide ensemble du type de topologie et du nombre de nœuds, pour éviter de surdimensionner la facture.
Vous recevez un devis détaillé : nombre de nœuds, stockage, durée, tarif par nœud et conditions de sortie.
Nos techniciens câblent les nœuds en InfiniBand et montent le stockage partagé. Ça se passe dans notre salle, pas chez vous.
On fait tourner un all-reduce sur toute la topologie, on compare aux valeurs attendues et on vous envoie le rapport.
Vous recevez le cluster clé en main, avec le monitoring branché et l'accès à votre ingénieur référent si le volume le justifie.
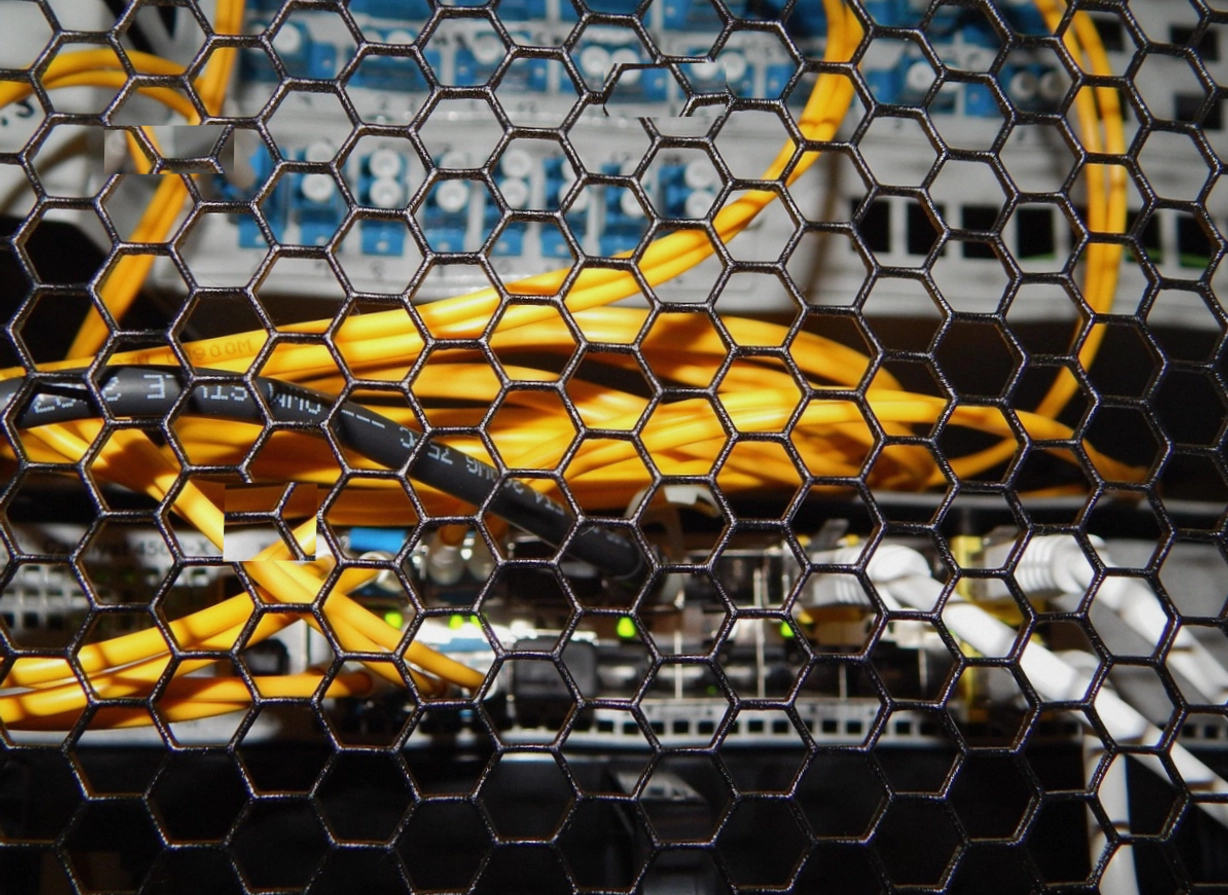
Quelques prises de vue de nos installations multi-nœuds et des outils qu'on livre avec.
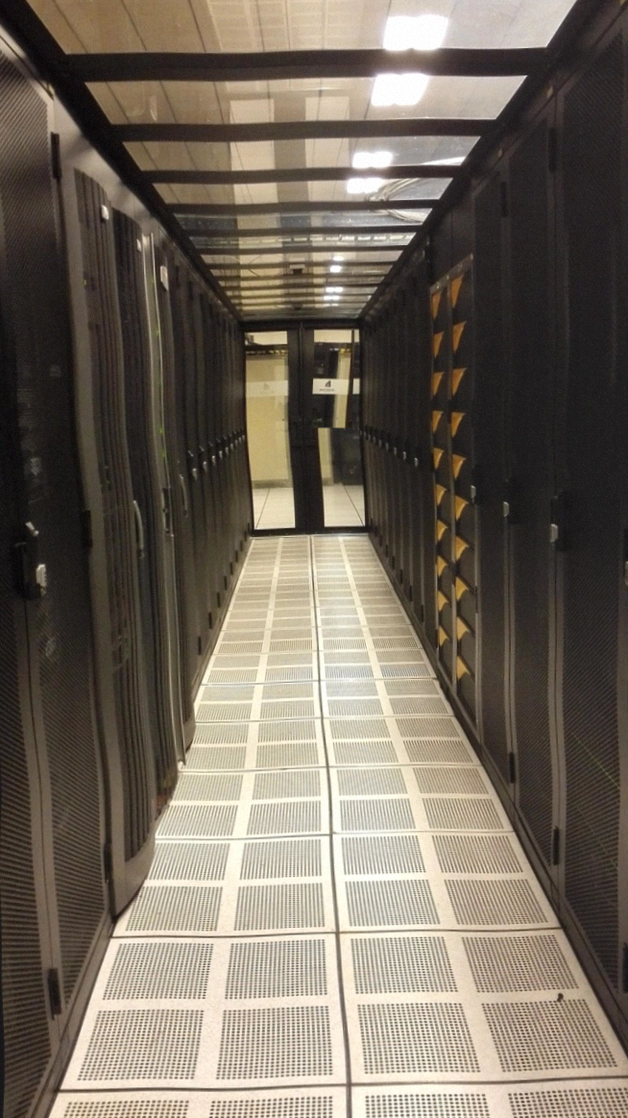
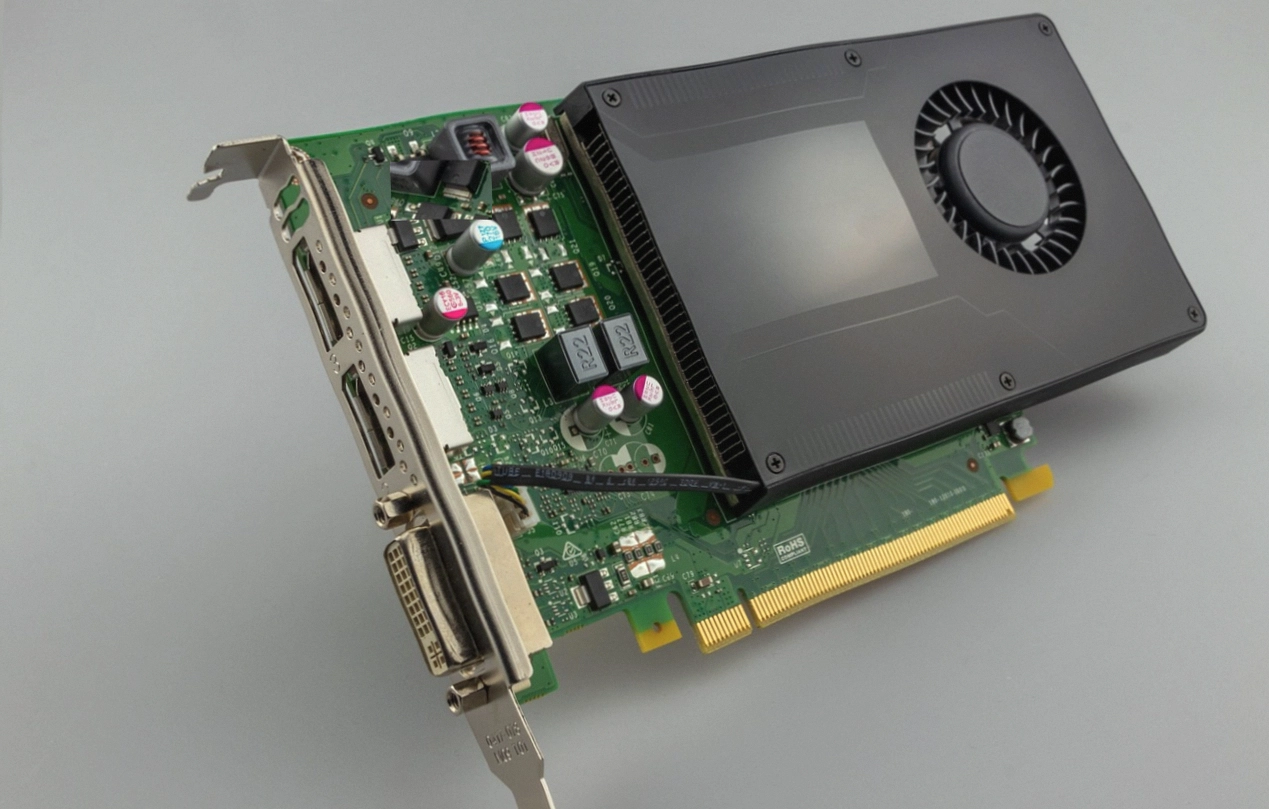
Pour tout ce qui touche au réseau ou au parallélisme, mieux vaut nous appeler directement.
Parler à un ingénieurOui, et c'est même recommandé. Beaucoup de clients démarrent sur 8 nœuds, mesurent leur scalabilité, puis étendent à 32 ou 64. On ajoute les nœuds sans redémarrer votre job, à condition de prévenir un peu à l'avance.
Le nœud qui ne fonctionne pas n'est pas facturé, et s'il perturbe un run en cours, les heures perdues vous sont créditées sur la facture suivante. On n'attend pas que vous réclamiez.
On sait les configurer, et on le fait volontiers dans le cadre d'une prestation d'intégration séparée. En dehors de ça, on vous garantit le cluster et le réseau, pas les bibliothèques tierces.
Techniquement oui, si vous avez un bucket S3 compatible. On le branche sur le cluster, mais le stockage partagé inclus reste plus rapide pour les checkpoints fréquents.
Comptez entre 8 et 14 jours ouvrés. La plupart du temps passé là-dedans, c'est la validation réseau, pas la préparation du matériel, qui est déjà en salle.
Vous avez 20 To par mois inclus, ce qui couvre largement le transfert de checkpoints. Au-delà, le tarif est de 0,005 € par Go, facturé à la fin du mois.
Plus vous nous donnez de détails sur le modèle et la stratégie de parallélisme, plus notre devis sera précis dès le premier retour.
Les demandes reçues le week-end sont traitées le lundi matin.